Dacă te întrebi „robots.txt sau noindex pentru pagini pe care nu vreau să le indexez”, răspunsul depinde de ce vrei să oprești: accesarea paginii de către crawler sau includerea ei în rezultatele căutării. Cele două mecanisme nu sunt interschimbabile. Pentru a cere excluderea unei pagini accesibile, folosește de regulă noindex și asigură-te că motorul de căutare o poate accesa ca să citească directiva. Folosește robots.txt pentru a controla accesarea URL-urilor, nu ca garanție că acestea dispar din rezultate. Mai jos găsești criterii de alegere, pași de verificare și greșeli de evitat.
| Punct | Detalii |
|---|---|
| Noindex controlează includerea în rezultate | Directiva trebuie să poată fi citită de crawler, fie dintr-o etichetă meta robots, fie dintr-un antet HTTP potrivit. |
| Robots.txt controlează accesarea | Fișierul stabilește reguli de crawling pentru anumite adrese, dar nu garantează excluderea lor din index. |
| Nu bloca pagina înainte ca noindex să fie citit | Dacă robots.txt împiedică accesul, crawlerul poate să nu vadă directiva noindex din pagină. |
| Pentru conținut confidențial, folosește controlul accesului | Nici robots.txt, nici noindex nu protejează datele și nu înlocuiesc autentificarea sau restricționarea accesului. |
| Verifică URL-ul final și răspunsul serverului | Redirecționările, erorile și antetele HTTP pot schimba comportamentul față de cel așteptat. |
Robots.txt sau noindex pentru pagini pe care nu vreau să le indexez: diferența de bază
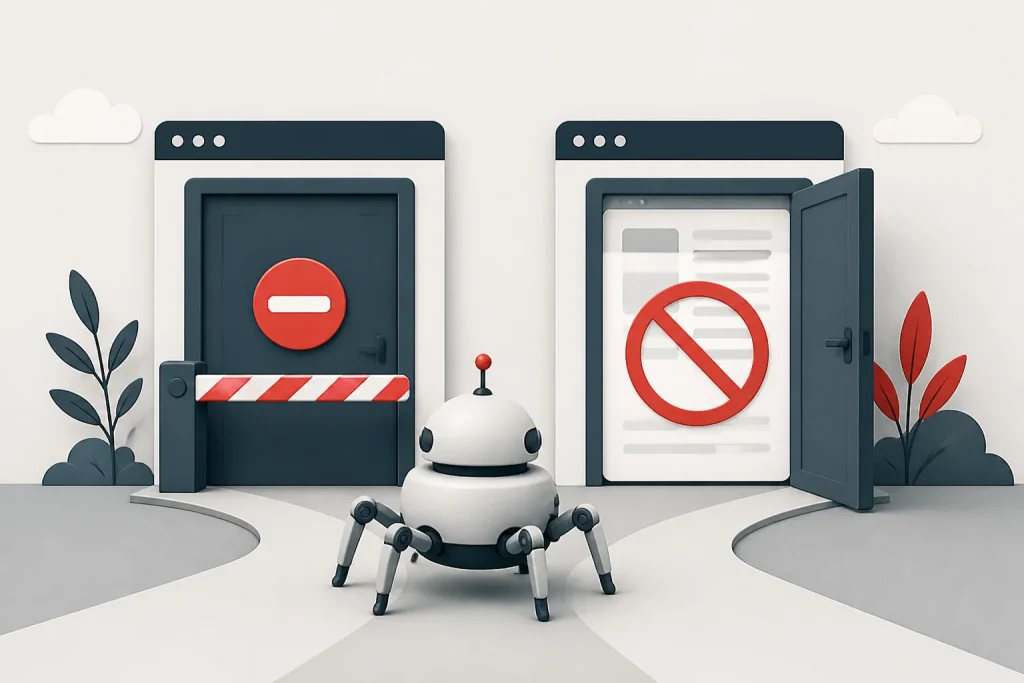
Robots.txt și noindex răspund la întrebări diferite. Robots.txt spune crawlerelor dacă pot accesa anumite URL-uri de pe site. Noindex este o directivă asociată unei pagini, care le cere motoarelor de căutare să nu o includă în rezultate. Pe scurt: primul privește accesarea, al doilea privește indexarea.
Indexarea este procesul prin care un motor de căutare analizează o pagină și o poate include în baza sa de rezultate. Crawlingul este accesarea paginii de către un robot automat. Crawlerul trebuie, în general, să poată accesa pagina pentru a descoperi și citi un noindex plasat în HTML sau într-un antet HTTP.
Blocarea într-un fișier robots.txt nu este o metodă sigură de eliminare din rezultate. Dacă altă pagină face legătura către URL-ul blocat, acesta poate fi descoperit fără ca motorul de căutare să-i poată citi conținutul. Prin urmare, nu presupune că lipsa accesului înseamnă automat lipsa din index.
- Definește întâi obiectivul: vrei să nu apară URL-ul în rezultate sau vrei să reduci accesarea lui de către crawler?
- Nu trata crawlingul și indexarea ca sinonime; configurarea corectă depinde de diferență.
Când este potrivit noindex
Alege noindex când pagina poate rămâne accesibilă utilizatorilor, dar nu vrei să apară ca rezultat de căutare. Exemplele pot include pagini de mulțumire, rezultate interne ale căutării, pagini de test disponibile public sau anumite variante cu valoare redusă pentru căutare. Acestea sunt exemple ipotetice; decizia trebuie să țină cont de scopul și structura site-ului.
Directiva poate fi transmisă printr-o etichetă meta robots în secțiunea head a documentului HTML sau printr-un antet HTTP X-Robots-Tag. A doua variantă poate fi utilă și pentru resurse care nu sunt pagini HTML, dacă serverul este configurat să trimită antetul potrivit.
Noindex nu este o măsură de securitate și nu împiedică accesarea paginii de către oameni. De asemenea, nu cere motoarelor să nu acceseze URL-ul; cere să nu îl păstreze în index după ce au putut citi directiva. Comportamentul și timpul de actualizare pot varia, deci nu promite o dispariție instantanee.
Cum aplici directiva
Într-o pagină HTML, directiva se adaugă în zona head printr-o etichetă meta robots cu valoarea noindex. Dacă se folosește un antet X-Robots-Tag, acesta trebuie configurat la nivelul serverului sau al platformei. Verifică sursa paginii și răspunsul HTTP, nu doar setările din interfața CMS.
Dacă directivele diferă între meta și antet, configurația poate deveni greu de interpretat și verificat. Păstrează o singură abordare clară acolo unde este practic și confirmă ce primește efectiv crawlerul.
- Asigură-te că URL-ul nu este blocat în robots.txt cât timp vrei ca crawlerul să citească noindex.
- Verifică dacă pagina răspunde normal și dacă directiva apare pe URL-ul canonic sau pe varianta efectiv accesată.
Când este potrivit robots.txt
Robots.txt este util când vrei să stabilești reguli de accesare pentru crawlere, de exemplu pentru a evita explorarea unor zone cu multe URL-uri repetitive sau pentru a limita accesul crawlerelor la anumite tipare de adrese. Regulile sunt instrucțiuni pentru roboții care le respectă, nu bariere tehnice de securitate.
Fișierul se publică la rădăcina gazdei relevante, iar regulile pot viza anumite căi și anumite grupuri de crawlere. O regulă prea largă poate afecta pagini importante sau fișiere de care depinde randarea lor. De aceea, o schimbare de robots.txt trebuie verificată cu atenție înainte și după publicare.
Dacă scopul este excluderea unei pagini din rezultate, robots.txt singur nu este alegerea potrivită. Dacă scopul este limitarea crawlării, iar apariția unui URL în rezultate nu reprezintă o problemă, blocarea poate avea sens. Pentru pagini care necesită confidențialitate, folosește autentificare sau alte controale de acces.
Ce nu face fișierul
Robots.txt nu șterge automat URL-uri deja indexate și nu ascunde conținutul de vizitatori. Nu oprește neapărat toți roboții și nu înlocuiește o directivă de indexare. Dacă o pagină este deja cunoscută, simpla adăugare a unei reguli de blocare poate să nu producă rezultatul dorit în căutare.
- Aplică reguli cât mai specifice și verifică dacă nu blochează accidental CSS, JavaScript sau pagini care trebuie accesate.
- Nu include informații sensibile în fișierul robots.txt; acesta este public și poate dezvălui căi de pe site.
Alegerea metodei în funcție de obiectiv
Pentru excluderea unei pagini accesibile din rezultatele căutării, alege de regulă noindex și permite accesul crawlerului suficient cât să citească directiva. Pentru controlul accesării unor secțiuni sau tipare de URL, folosește robots.txt. Dacă ai ambele obiective, planifică ordinea: crawlerul trebuie să poată citi noindex înainte să fie blocat.
Exemplu ipotetic: o pagină de confirmare după trimiterea unui formular este publică, dar nu are valoare ca rezultat de căutare. Poți aplica noindex și poți evita blocarea ei în robots.txt, astfel încât directiva să fie accesibilă. În schimb, o zonă cu URL-uri generate automat poate necesita reguli de crawlare, dar asta nu garantează că adresele respective nu vor apărea în rezultate.
Pentru un conținut privat, nu alege între aceste două opțiuni ca și cum ar fi soluții de protecție. Solicită autentificare, limitează accesul la server sau folosește mecanisme adecvate platformei. O pagină publică marcată noindex poate fi totuși deschisă de oricine îi cunoaște adresa.
Regulă rapidă de decizie
Întreabă-te: trebuie să nu apară URL-ul în căutare? Folosește noindex, cu acces permis pentru citirea directivei. Trebuie să reduci accesarea anumitor URL-uri? Evaluează robots.txt. Trebuie să împiedici accesul public? Configurează protecție tehnică, nu o directivă SEO.
- Notează obiectivul fiecărei reguli înainte de implementare și păstrează o evidență a URL-urilor afectate.
- Dacă o pagină trebuie să rămână indexabilă, nu o marca accidental noindex printr-un șablon comun.
Cum gestionezi combinația dintre robots.txt și noindex
Cea mai frecventă contradicție este aplicarea simultană a unei blocări în robots.txt și a unui noindex pe aceeași adresă. Dacă crawlerul nu poate accesa pagina, este posibil să nu vadă meta tagul din HTML sau antetul HTTP. În acest caz, configurația nu transmite în mod fiabil instrucțiunea de excludere pe care o urmărești.
Dacă pagina trebuie scoasă din index și este accesibilă, las-o temporar accesibilă crawlerului și aplică noindex. După ce ai confirmat că directiva este livrată corect și că pagina a fost recitită, reevaluează dacă mai ai un motiv separat să limitezi crawlarea. Nu bloca automat URL-ul imediat după adăugarea directivei.
Dacă URL-ul este deja blocat și apare în rezultate, trebuie să înțelegi mai întâi cum a fost descoperit și ce semnale sunt disponibile. O intervenție pripită poate menține problema, fiindcă robotul nu poate accesa pagina pentru a citi modificările. Verifică regulile, linkurile interne și răspunsul efectiv al serverului înainte să schimbi configurația.
- Nu folosi blocarea ca scurtătură pentru a face noindex inaccesibil.
- Testează separat fiecare mecanism: accesul prin robots.txt, prezența directivei și răspunsul paginii.
Pași practici pentru implementare și verificare
Înainte de orice modificare, stabilește URL-urile exacte și motivul pentru care fiecare trebuie exclus sau limitat. Nu aplica o regulă la nivelul întregului site doar pentru că ai identificat o singură pagină problematică. Verifică și dacă URL-ul are parametri, variante cu slash final, versiuni diferite ale protocolului sau redirecționări.
Apoi inspectează pagina: codul HTML livrat, meta robots, antetele HTTP, codul de răspuns și regulile din robots.txt. Într-un CMS, verifică atât setarea paginii, cât și șablonul sau pluginul care ar putea suprascrie directiva. O setare vizibilă în panoul de administrare nu dovedește singură ce primește crawlerul.
După publicare, verifică din nou URL-ul și confirmă că motorul de căutare îl poate accesa dacă trebuie să citească noindex. Folosește instrumentele disponibile pentru proprietatea site-ului ca să inspectezi pagina și starea raportată, dar interpretează rezultatele în funcție de momentul ultimei accesări. Schimbările nu se reflectă obligatoriu imediat.
Listă de control înainte de publicare
Confirmă obiectivul; verifică exact URL-ul final; caută reguli robots.txt care îl afectează; inspectează meta tagul și antetul HTTP; verifică dacă există redirecționări sau etichete contradictorii; testează pe un set restrâns de pagini înainte să extinzi regula.
- Păstrează o copie a configurației anterioare pentru a putea reveni rapid dacă sunt afectate pagini importante.
- Verifică periodic paginile-șablon, mai ales după schimbări de temă, plugin sau platformă.
Greșeli frecvente și cum le eviți
Prima greșeală este să presupui că Disallow într-un fișier robots.txt înseamnă „șterge această pagină din Google”. Regula privește accesarea, nu constituie o comandă de eliminare din index. Dacă pagina trebuie exclusă, folosește o directivă de indexare accesibilă crawlerului sau analizează mecanismul potrivit situației.
A doua greșeală este să adaugi noindex, apoi să blochezi imediat aceeași pagină. Astfel, poți împiedica tocmai citirea directivei. A treia este să folosești noindex pentru conținut confidențial; pagina rămâne publică și poate fi accesată direct.
O altă problemă este aplicarea regulii pe o cale prea generală. O eroare de tipar sau o regulă extinsă poate afecta categorii, produse sau resurse importante. Înainte de publicare, verifică exemple de URL-uri care ar trebui blocate și exemple care trebuie să rămână accesibile. Repetă testul după implementare.
- Evită modificările masive fără inventarierea adreselor afectate.
- Nu considera o adresă absentă dintr-o listă de pagini indexate ca dovadă suficientă că directiva funcționează; verifică setările și accesibilitatea ei.
Cum alegi în funcție de tipul paginii
Pentru pagini de mulțumire sau confirmare, care sunt publice dar nu utile ca destinații din căutare, noindex este de obicei mai apropiat de obiectiv. Asigură-te că pagina nu este blocată înainte de citirea directivei și că funcționarea formularului nu depinde de o schimbare accidentală a șablonului.
Pentru filtre și sortări dintr-un magazin online, decizia cere mai mult context. Unele combinații pot avea valoare pentru utilizatori, altele pot crea multe URL-uri aproape identice. Nu bloca automat toate filtrele: evaluează structura adreselor, utilitatea paginilor și modul în care sunt generate linkurile interne. Regulile de crawlare și directivele de indexare au efecte diferite.
Pentru pagini de staging, administrare sau conținut privat, noindex nu este suficient. În special, un mediu de test trebuie protejat prin autentificare sau control de acces și gestionat atent la lansare, ca să nu rămână accidental blocat ori marcat noindex. Alege metoda după funcția paginii, nu doar după tipul ei.
Criteriul care contează cel mai mult
Întreabă dacă pagina trebuie să poată fi citită de public, dacă trebuie să fie accesată de crawler și dacă este acceptabil să fie descoperită fără conținut în rezultatele căutării. Răspunsurile separă nevoile de indexare, crawlare și securitate.
- Pentru pagini generate automat, testează o mostră de URL-uri și verifică efectele regulilor asupra întregii familii.
- La lansarea unui site, verifică să fie eliminate blocările și directivele de test care nu mai sunt dorite.
Întrebări frecvente
Pot folosi robots.txt ca să elimin o pagină din rezultatele Google?
Nu te baza pe robots.txt pentru eliminarea din index. Acesta controlează accesarea, iar un URL blocat poate fi cunoscut din alte surse. Pentru o pagină accesibilă care nu trebuie inclusă în rezultate, folosește noindex și permite crawlerului să citească directiva.
Pot avea noindex și o regulă Disallow pentru aceeași pagină?
Este o combinație care poate fi contraproductivă: dacă URL-ul este blocat, crawlerul poate să nu citească noindex. Dacă urmărești excluderea din rezultate, lasă pagina accesibilă până când directiva poate fi procesată.
Noindex protejează o pagină cu informații private?
Nu. Noindex nu restricționează accesul oamenilor și nu este un mecanism de securitate. Folosește autentificare sau controale de acces adecvate pentru conținutul care nu trebuie să fie public.
Unde se poate seta noindex?
De regulă, în HTML printr-o etichetă meta robots sau într-un antet HTTP X-Robots-Tag. Verifică pagina livrată efectiv, fiindcă setările CMS-ului, șabloanele și antetele serverului pot influența rezultatul.
Cât durează până când o pagină nu mai apare în rezultate?
Nu există un termen universal pe care să-l poți garanta. Depinde de accesarea și procesarea ulterioară a paginii de către motorul de căutare. Confirmă că URL-ul este accesibil crawlerului și că directiva noindex este transmisă corect.
Concluzie
Alege noindex când obiectivul este excluderea unei pagini accesibile din rezultatele căutării și robots.txt când vrei să controlezi accesarea anumitor URL-uri. Nu bloca crawlerul înainte să poată citi directiva și nu folosi niciuna dintre metode pentru a proteja informații private. Inventariază paginile, verifică răspunsul real al serverului și testează regulile înainte să le extinzi pe întregul site.